P1047 校门外的树
关于提问其他解法的回答
方同学您好!的确,这是一道非常经典的题目,我也想到了几种不同的解法。考虑到我所整理的这些解法在各大 OJ 上少有如此全面的汇总,且自认为比 AI 给出的回答更易懂、更系统,故写下此文,解答您关于此题其他解法的疑问。
本文使用了 Markdown 和 语法。如果在这里不能正常显示的话,可以在 我的个人网站 或 我的这篇洛谷题解 上更好地查看。
此题是 2005 年 NOIP 普及组的第 2 题,名为「校门外的树」,这里是洛谷 OJ 上的 题目链接。
此外,值得一提的是,原题时间限制是 1.00 s、内存限制是 125.00 MB。原题的数据范围如下:
- 对于 的数据,保证区域之间没有重合的部分。
- 对于 的数据,保证 ,,。
题解
朴素解法
请允许我先简要描述一下您的算法。
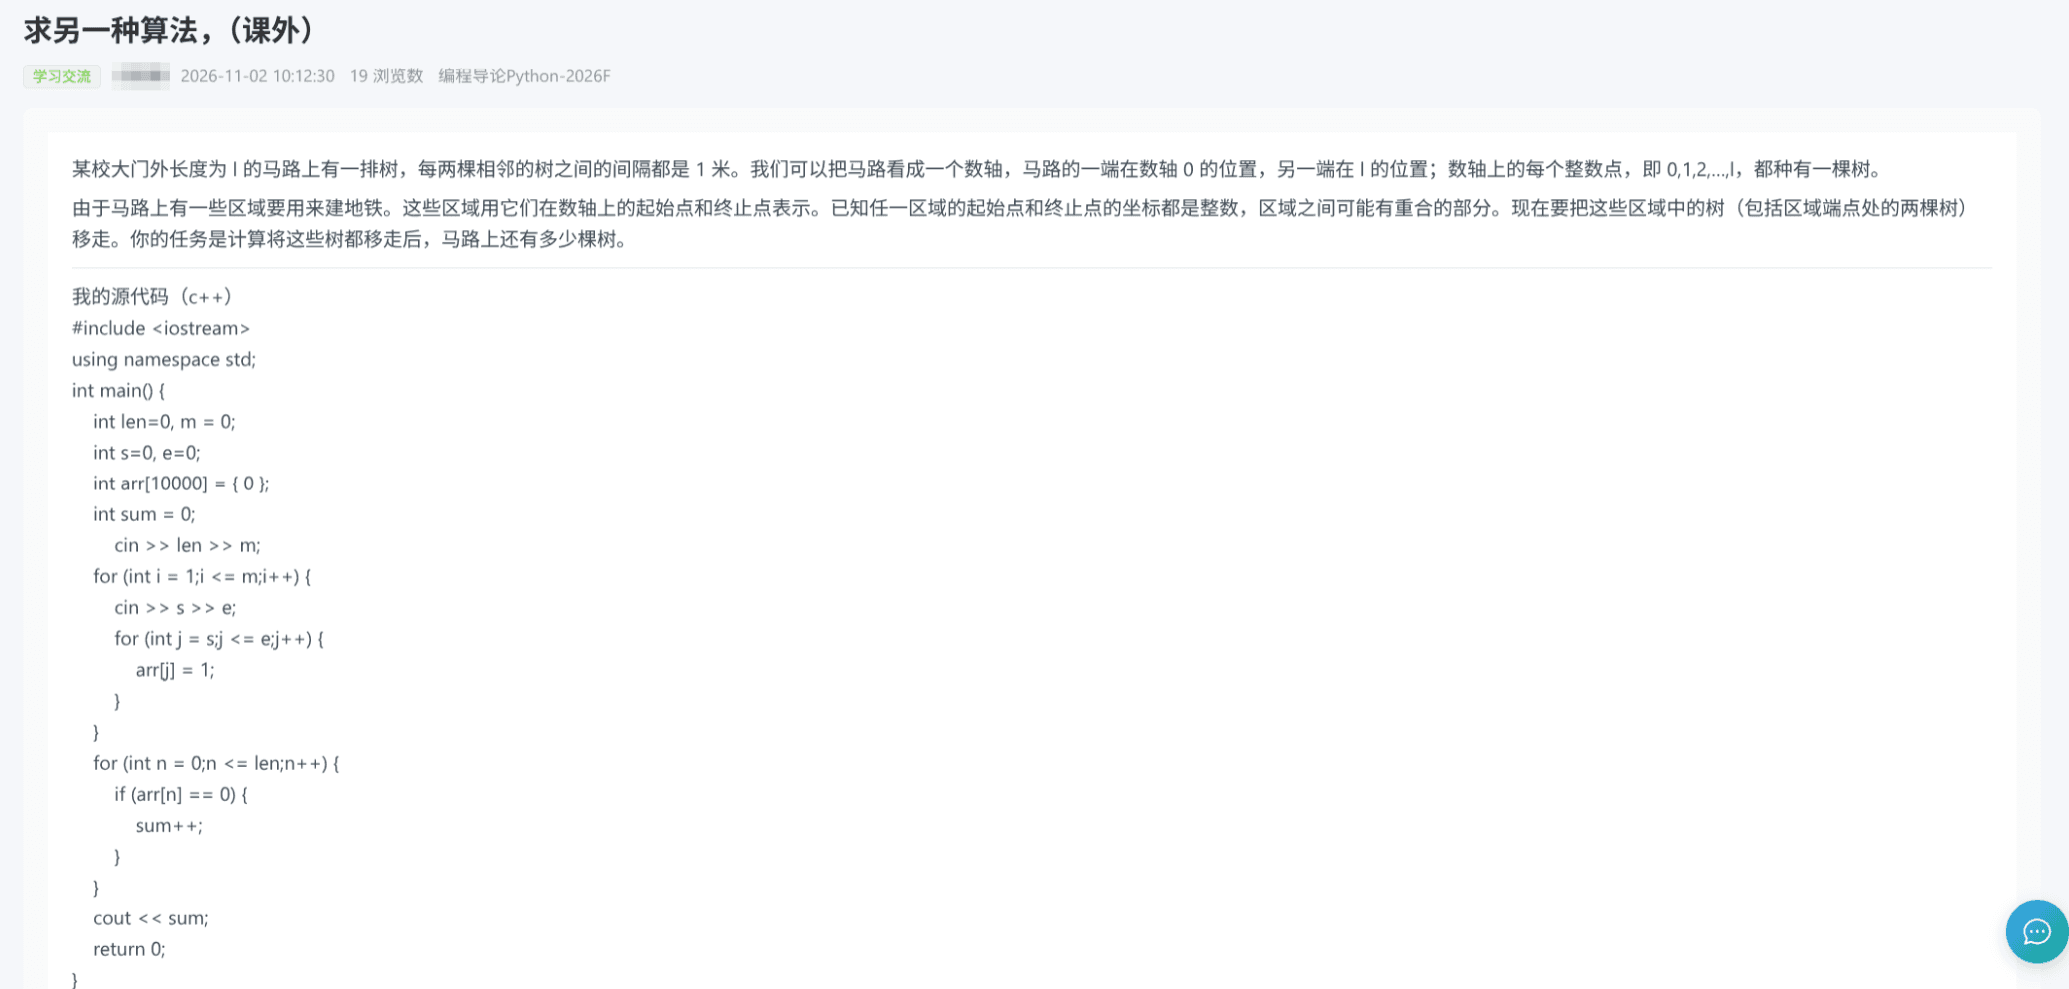
对于这样的数据范围,我们可以定义一个长度为 的布尔数组,记录每棵「树」是否需要被「移走」。对于每次区间移除操作(一共 次),把该区间内的每一棵树都标记一下(最多标记 棵树),即使重复标记也不影响结果。最后,再遍历一遍这个标记好的布尔数组,找出没有被标记的树——即被保留的树的个数。
由此,上述算法的时间复杂度是 ,空间复杂度为 。对于此题而言绰绰有余,但是您也发现了,这看起来并不像最优解。
#include <...>
using namespace std;

int main() {
    int l, m; cin >> l >> m;
    bitset<size_t(1e4 + 9)> bl;
    for (int _ = 1, u, v; _ <= m; ++_) {
        cin >> u >> v;
        for (int i = u; i <= v; ++i)
            bl[i] = true;
    }
    int ans = 0;
    for (int i = 0; i <= l; ++i)
        ans += bl[i];
    cout << l + 1 - ans;
    return 0;
}
差分
说实话,这道题最适合的算法便是差分。差分思路简单又常用,应当也是本题时间复杂度最优的算法。不过需要注意,差分也不是万能的,它更适合离线(只在最后统一查询)、 较小的情况。
本题可以转化为:初始有一个长度为 、元素全为 的数组。对于每次区间操作 ,考虑将该区间内的所有数自增 。最后,数组中仍然为 的元素个数即为最终答案。
而差分的算法理念便是如此:差分可以在 的时间复杂度下进行区间修改,在 的时间复杂度下进行查询。本题的时间复杂度即为 。从乘积变成加法,时间复杂度大大降低,足以应对 极大的情况;而由于空间复杂度为 ,它要求 不能过大,原因便在于此。
如果您没有学过差分,非常建议您先学习「前缀和」算法,再自己推导一下「差分」算法,两者均简单易写。当然,您也可以参考我如下的简要表述和代码:
对于一个数组 ,考虑记录差分数组 ,其中 。也就是说,我们记录原 数组中相邻两数之差。特别地,为了计算方便, 数组是 1-indexed 的(下标从 开始),规定 。
如何从 反推 的值?通过拆分 可知:
差分如何优化区间自增?显然,对于区间 中的每个数自增 ,只需要把 ,且 。其中前者影响了 的每一个值,而后者消除了前者对于 的影响,故使得有且仅有 完成了自增修改。
#include <...>
using namespace std;

int main() {
    int l, m; cin >> l >> m;
    vector<int> s(l + 2, 0);
    for (int _ = 1, u, v; _ <= m; ++_) {
        cin >> u >> v; ++u, ++v;
        s[u] += 1, s[v + 1] -= 1;
    }
    int ans = 0;
    for (int i = 1, a = 0; i <= l + 1; ++i) {
        a += s[i];
        ans += a == 0;
    }
    cout << ans;
    return 0;
}
区间合并
上述两种算法都需要开一个长度约为 的数组,空间复杂度为 。如果题目的 巨大,比如 最大为 (仍在 C++ long long 数据范围内),这样的情况在算法题中很常见,而上述两种算法无论如何也无法在有限的空间限制下运行。下面介绍的区间合并(同样为离线算法)则可以很好地解决这一问题。
考虑将所有区间 按照其左端点 进行升序排序。维护一个当前正在合并的区间 ,遍历下一个区间 :
- 如果 ,则说明区间 和区间 是可以合并的,更新 。
- 否则,这两个区间是分离的,计算新贡献的「被移走的树」的数量 ,并更新 ,。
该算法时间复杂度为 ,空间复杂度为 ,勉强可以算是结合了排序和贪心的思路,但主要还是用到了离线的思想,对操作区间进行了重新排序处理。
为了体现该算法可以适应较大的 值,以下代码中将所有存储树的位置的变量都用了 long long 存储。
#include <bits/stdc++.h>
using namespace std;
using ll = long long;

int main() {
    ll l; int m; cin >> l >> m;
    vector<pair<ll, ll>> d;
    d.reserve(m);
    for (int _ = 1; _ <= m; ++_) {
        ll u, v;
        cin >> u >> v;
        d.push_back({u, v});
    }
    sort(d.begin(), d.end());
    ll ans = 0;
    auto [L, R] = d.front();
    for (auto [u, v] : d) {
        if (u <= R + 1) R = max(R, v);
        else {
            ans += R - L + 1;
            L = u, R = v;
        }
    }
    ans += R - L + 1;
    cout << (l + 1) - ans;
    return 0;
}
树状数据结构
同样,树状数据结构也可以应对 较大的情况,而其优势在于支持在线操作,能够随时修改、查询,并支持任意交替操作。本题可以用动态开点线段树或珂朵莉树实现。
鉴于两者属于数据结构中偏后的知识点,在此便不再向您展开描述这两种算法了。希望您可以在日后学习到树状数据结构时留个心,更深刻地感受它们的强大之处:在线、对数时间复杂度、灵活支持各种操作。当然,如果您想了解树状数据结构是如何实现本题的,或者想要入门学习数据结构,非常欢迎随时联系我,我很高兴为您提供更多思路。
在东北林业大学的空闲时间极少,我用于思考本题、解题及撰写本文的时间亦十分有限。同时,从高二打完最后一次正式比赛后,我也没再系统学习过信奥赛的算法。限于我学习算法的时间与深度、自身的能力,以及时间的磨损,我关于这道题的算法分享只能帮您到这里,希望这篇题解能解答您的疑问。
碎碎念
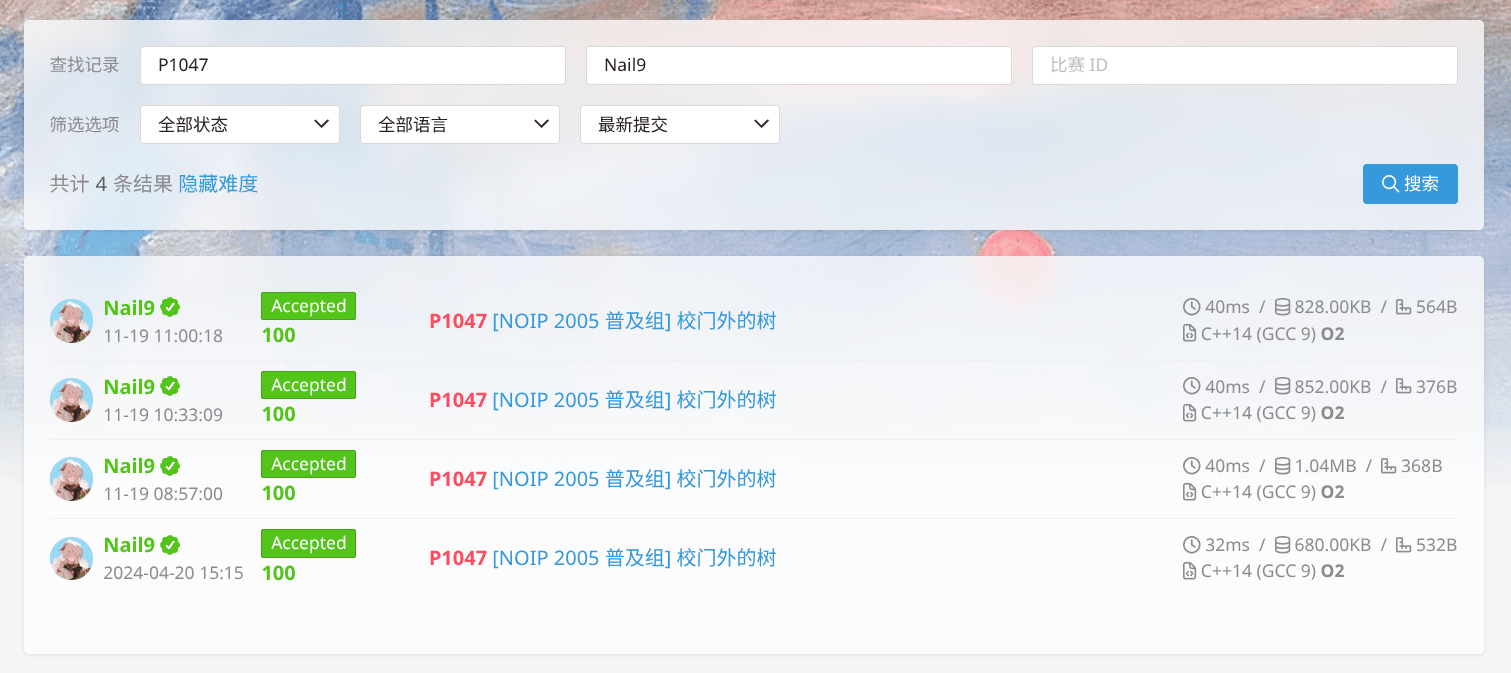
方同学,看到您的提问,令我回想起我最开始打信息学奥林匹克竞赛(信奥赛)的时光。这道题的洛谷难度评级为「入门」,而且作为 NOIP 真题和老题,可以算是我高一刚开始学习信奥赛算法时「抱过我」的题目。从洛谷的评测记录可以看到,我在 2024 年 4 月 20 日做的这道题。但这样的回忆还不至于让我如此触动,更重要的是看到了您提问这道题是否有其他解法。
我自始至终都是「自学」信奥赛,没有教程、没有教练,得知了「洛谷」这一 OJ 后,便从简单题到难题没有顺序地思考解法、在黑暗中摸索。我会把一道题打印出来,在高中时,不管是上课、下课还是在图书馆,都在思考这一道题,把代码手写在纸上,回家后再测试是否通过。如果苦思了好几天仍没有攻破,再去看题解,学习那些能够通过的学长们的思路。在这样的摸索中,我时常有一个深刻的感受:「题解的解法真的是最优的吗?」我一直能隐约感受到哪里还存在着一个最优解,也深深觉得自己没做出某道题,并不是因为没有能力想到题解所谓的「正确」解法,而是我在想到一半时认为它不够最优便放弃了,一直在追寻我心中的「最优解」。然而限于当时的能力,每道没做出来的题目我都只能阅读题解、就此作罢,从来没有真正追寻到我心中的「最优解」。
直到今天,我看到了您的这则提问。读完题目后,一如既往地,我跳过了上述题解所说的、也是您所列出的「朴素解法」。但和以往不同的是,我的脑海中终于冒出了一个个优化后的方法——差分、线段树、区间合并……可想而知,在 2024 年 4 月 20 日下午 3:15,那个平凡的星期六,我不得不妥协地提交了这道题并非最优的解法时是怎样的心情。当然,我也不会想到,在两年后的今天,我在读题的一瞬间便想到了此题更优的解法,追寻到了曾经梦寐以求的「最优解」,也证明了我当初对「最优解」的直觉并没有错,我仍然走在对算法追求的道路上。
当您提问这道题的其他解法时,或许您也有着和我类似的关于算法的追求。无论如何,感谢您的这则提问,让我在您身上看到了自己当年的影子,也感谢您圆了我追寻「最优解」的梦想。这道题或许已经找到了「最优解」、到达了终点,但你我的算法之路仍然长远。算法是 AI 时代下计算机科学少有的奥秘,是我高中宝贵时光的寄托,也是我一生的梦想和追求。我会继续探寻这充满奥秘的算法世界,也祝您在算法的道路上收获成功,收获乐趣!
附件
原提问
我本题的提交记录